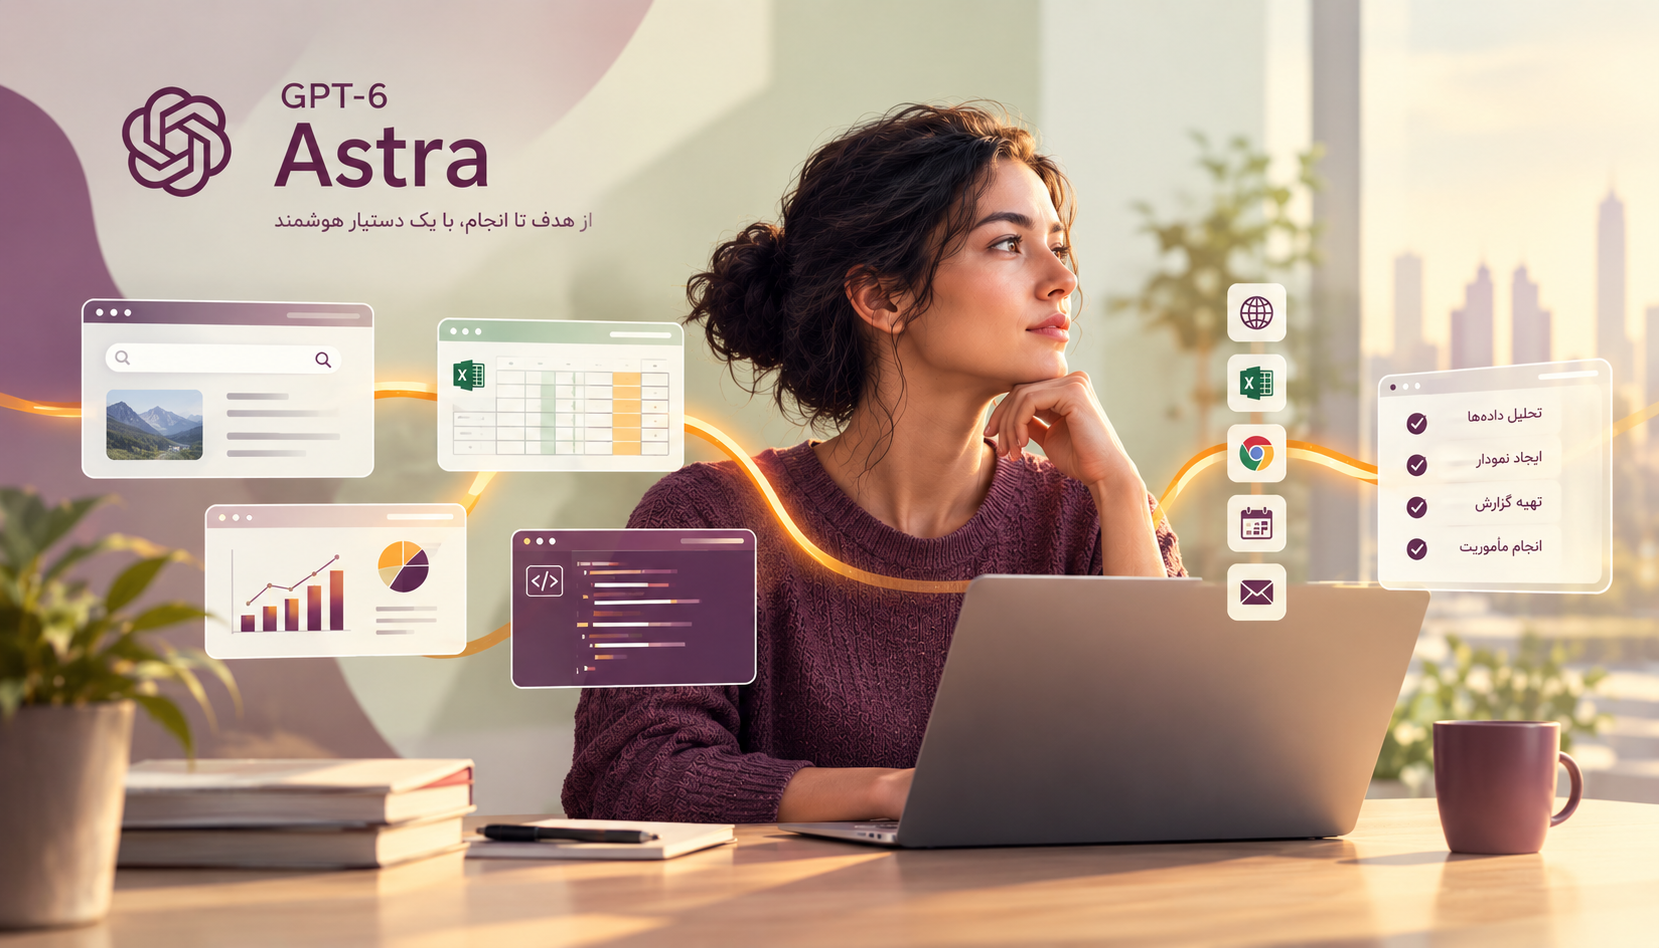
هوش مصنوعی در سالهای اخیر از مرحلۀ پاسخ به مرحلۀ انجام نزدیک شده است. Astra مدل جدید GPT‑6 از شرکت OpenAI که اوایل سپتامبر معرفی شد، مدلی است که مرز میان یک چتبات معمولی و یک دستیار هوشمند را جابجا کرده و با ورود به محیط واقعی رایانه، مانند یک انسان با مرورگر، اکسل و نرمافزارهای تخصصی کار میکند. تغییری که در صورت تحقق، رابطه کاربر با نرمافزار را از حالت ابزارمحور به هدفمحور منتقل میکند.
در مدلهای رایج، کاربر مسیر را مشخص میکند و مدل تنها بخشهایی از کار را انجام میدهد؛ اما طبق ادعاهای مطرحشده، Astra قرار است این روند را معکوس کند: کاربر هدف را بیان میکند و مدل مسیر رسیدن به آن را میسازد. این رویکرد در ادبیات هوش مصنوعی با عنوان عاملیت شناخته میشود و یکی از گامهای مهم در توسعه دستیارهای خودمختار محسوب میشود.
از پاسخگویی تا انجام مأموریت
از میان قابلیتهایGPT‑6 Astra، «عاملیت» و «استفاده از رایانه» پرتکرارترین محورهایی هستند که در این مدل مورد توجه قرار گرفتهاند؛ هرچند صفحه رسمی OpenAI معرفی Astra را حول چهار محور میچیند: استفاده از رایانه، برنامهنویسی، امنیت سایبری و کمک به تحقیقات و کارهای علمی.
منظور از عاملیت این است که مدل صرفاً منتظر دریافت دستورهای کوتاه و مرحلهبهمرحله نمیماند، بلکه میتواند هدف کلی کاربر را دریافت کرده و برای رسیدن به آن برنامهریزی کند. برای مثال، کاربر میتواند از مدل بخواهد دادههای یک فایل را بررسی کند، نتایج را در یک جدول اکسل وارد کند، نمودار بسازد و در پایان گزارشی آماده کند و کارهای روزمره مثل سفارش غذا، رزرو زمین تنیس یا فروش وسایل را انجام دهد. Astra توانایی مدیریت این زنجیرۀ کاری را دارد؛ حتی اگر برای انجام آن به چند نرمافزار مختلف نیاز باشد.
این قابلیت در صورت عملکرد پایدار، میتواند کاربرد مدلهای زبانی را از گفتوگو و تولید متن فراتر ببرد و آنها را به دستیارانی تبدیل کند که مستقیماً با محیط دیجیتال کار میکنند.
عملکرد چشمگیر در آزمونها
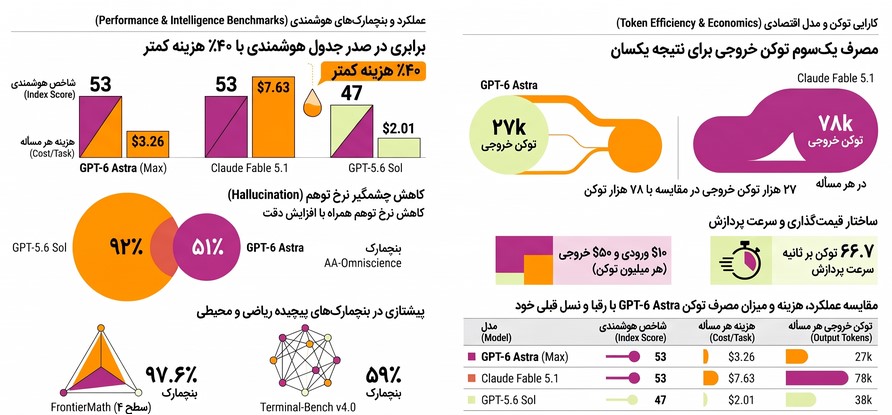
طبق جدول رسمی OpenAI این مدل در آزمونهای زیر امتیازهای قابلتوجهی کسب کرده است:
99.9% در 3ARC‑AGI‑ ــ آزمونی برای سنجش استدلال انتزاعی
۹۷.۶٪ درFrontierMath Tier4 ــ یک آزمون خیلی سخت ریاضی در سطح تحقیقاتی
۹۵.۹٪ در BenchCAD ــ آزمونی برای سنجش توانایی در کارهای مهندسی/طراحی CAD
۷۴.۱٪ در1.1 DeepSWE v ــ آزمونی برای سنجش توانایی برنامهنویسی و مهندسی نرمافزار در پروژههای واقعی
نکته جالب اینکه امتیاز Astra درFrontierMath Tier4 ، بیشتر از مدلهای رقیب مثل Claude Fable5.1 با ۸۷.۸% است، اما در آزمون 1.1 DeepSWE v فاصلهاش با بقیه مدلها مثلClaude Opus5 با ۷۳.۷٪ یا Gemini 3.8Flash با ۷۳.۸٪ بسیار کم و تقریباً همسطح هستند.
طبق گزارش فایننشالتایمز،Astra در مسابقه Financial Modeling World Cup عملکردی بهتر از انسانها داشته و در کارهایی مثل تنظیم اظهارنامه مالیاتی، تحلیل داده و پر کردن فرمهای وقتگیر هم نتایج خوبی گرفته است.
با این حال، یکی از نکات مهم دربارۀ چنین بنچمارکهایی، شیوۀ اجرای آزمون است. استفاده از زیرساخت اختصاصی، زمان پردازش بیشتر یا ابزارهای کمکی میتواند بر نتیجه اثر بگذارد. به همین دلیل، مقایسۀ مستقیم امتیازها زمانی معنا پیدا میکند که همۀ مدلها در شرایط یکسان ارزیابی شده باشند. از طرف دیگر تقریباً تمام این ادعاها از نتایج بنچمارکها تا دموهای نمایشی، بر پایه موادی است که خود OpenAI انتخاب و منتشر کرده و یک ارزیابی کاملاً مستقل نیست.
ادعای کشف آسیبپذیریهای ناشناخته
یکی دیگر از ادعاهای مطرحشده دربارۀ Astra، توانایی آن در شناسایی آسیبپذیریهای ناشناختۀ امنیتی است. گفته میشود مدل در آزمونهای امنیت سایبری توانسته بهتنهایی برخی حفرههای امنیتی ناشناخته را پیدا کند و برای آنها روش سوءاستفاده (اکسپلویت) واقعی و کارآمد بسازد؛ قابلیتی که OpenAI بر مبنای آن، Astra را به «آستانۀ بحرانی امنیت سایبری» رسانده است.
چنین توانایی میتواند در کشف سریعتر ایرادهای امنیتی، بررسی کدهای پیچیده و واکنش به حملات سایبری مفید باشد. البته همین قابلیت، نگرانیهایی هم ایجاد میکند؛ زیرا ابزارهایی که میتوانند آسیبپذیری پیدا کنند، در صورت استفادۀ نادرست ممکن است برای حمله به سامانهها نیز به کار گرفته شوند. بنابراین کنترل دسترسی، ثبت فعالیتها و تعیین محدودیتهای امنیتی، احتمالاً بخش مهمی از عرضۀ این مدل خواهد بود.
«به عصر AGI خوش آمدید»
گرگ براکمن، رئیس و از بنیانگذاران OpenAI، عرضۀ Astra را آغازگر عصر AGI دانسته است. AGI یا هوش مصنوعی عمومی، به سامانهای گفته میشود که بتواند در طیف گستردهای از فعالیتهای فکری، عملکردی نزدیک به تواناییهای انسان داشته باشد.
با این حال، رسیدن یک مدل به توانایی انجام وظایف پیچیده، استفاده از نرمافزارها یا کسب امتیاز بالا در آزمونهای دشوار، بهتنهایی به معنای تحقق کامل AGI نیست. هوش عمومی، علاوه بر حل مسئله، به درک پایدار، یادگیری انعطافپذیر، تصمیمگیری قابل اعتماد و عملکرد مناسب در موقعیتهای ناشناخته نیاز دارد.
به همین دلیل، حتی اگر GPT‑6 Astra در عمل بسیار قدرتمند باشد، احتمالاً بحث دربارۀ اینکه آیا واقعاً باید آن را AGI نامید، همچنان ادامه خواهد داشت.
مدل گرانقیمت برای مأموریتهای پیچیده
در گزارشهای مربوط به قیمتگذاری Astra، هزینهای حدود 10 دلار برای هر یک میلیون توکن ورودی و 50 دلار برای هر یک میلیون توکن خروجی مطرح شده است. چنین رقمی آن را در دستۀ مدلهای گرانقیمت قرار میدهد و قدرت اصلیاش در توانایی انجام مأموریتهای پیچیده و چندمرحلهای است. پس بهجای این پرسش که کدام مدل قویتر است، پرسش عملیتر این است که آیا استدلال بیشتر Astra، در کار مشخصی که پیشرو داریم، نتیجه را آنقدر بهبود میدهد که هزینه اضافهاش را توجیه کند. کارهایی که اطلاعات لازم برای حل آن پراکنده و پیچیده هستند، گزینه بهتری برای چنین مدلی است؛ در حالی که کارهایی که یک مدل ارزانتر هم با اعتماد بالا انجام میدهد، معمولاً توجیهی برای این هزینه اضافه ندارد.
عرضۀ محدود و دسترسی مرحلهای
بر اساس اطلاعات منتشرشده، دسترسی اولیه به GPT‑6 Astra از طریق دو برنامه Trusted Access (برای سازمانهای عمومی) و Daybreak (برای شرکای امنیت سایبری) برای گروه محدودی از سازمانها آغاز شده است. گفته میشود کاربران ChatGPT Plus، Pro، Business و Enterprise و همچنین توسعهدهندگان API، طی روزهای آینده بهصورت مرحلهای به این مدل دسترسی پیدا خواهند کرد.
این نوع عرضۀ تدریجی به شرکت اجازه میدهد عملکرد مدل را در شرایط واقعی بررسی کند، ظرفیت زیرساختی را افزایش دهد و خطرهای احتمالی مربوط به خودکارسازی فعالیتهای حساس را بهتر مدیریت کند. این شیوه عرضه محدود و مرحلهای، الگوی تازهای در صنعت هوش مصنوعی نیست و اوپنایآی از الگویی پیروی میکند که آنتروپیک با مدل میتوس 5 انجام داد و بهجای دسترسی آزاد و عمومی، در دوزهای اندازهگیری شده برای سازمانهای منتخب و همراه با محدودیتهای داخلی ارائه میشود.
اگر قابلیتهای نسبتدادهشده به Astra درست باشد، تغییر اصلی این مدل نه فقط در تعداد پارامترها یا امتیازهای بنچمارک، بلکه در نوع رابطۀ انسان و نرمافزار خواهد بود.
در آینده، کاربر دیگر مجبور نیست مسیر انجام کار را دقیق بداند. کافی است هدفش را توضیح دهد و مدل، خودش ابزار مناسب را انتخاب کند، مراحل کار را پیش ببرد، خطاها را اصلاح کند و نتیجۀ نهایی را تحویل دهد.
البته میان یک نمونۀ نمایشی و محصولی که بتواند در دنیای واقعی، بدون خطا و نظارت دائمی کار کند، فاصلۀ زیادی وجود دارد. موفقیت واقعی Astra به این بستگی دارد که در کنار قدرت استدلال، تا چه اندازه قابل اعتماد، ایمن، شفاف و مقرونبهصرفه باشد.

1 دیدگاه
به گفتگوی ما بپیوندید و دیدگاه خود را با ما در میان بگذارید.